서비스 화면

PDF 정보 추출 시스템
PDF 정보 추출 시스템
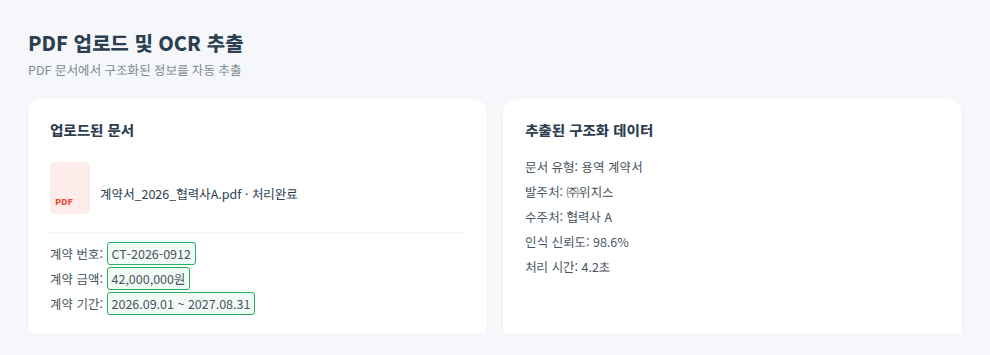 PDF 업로드 및 OCR 추출
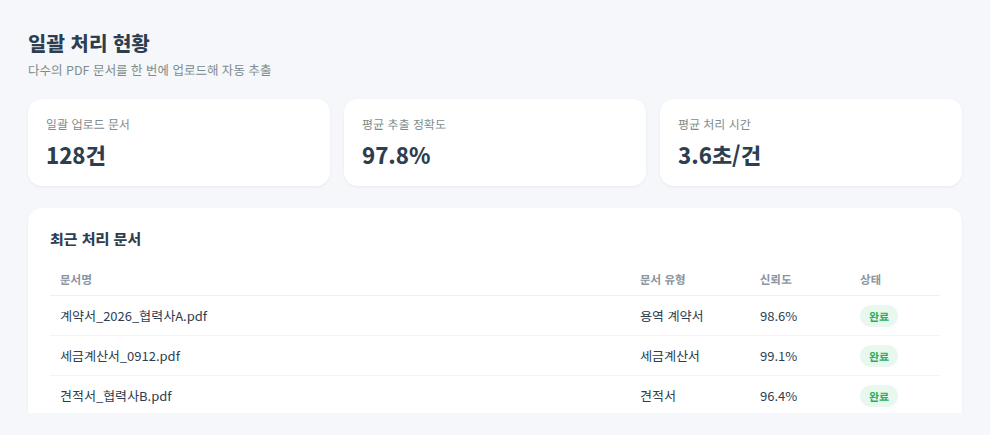 일괄 처리 현황
PDF 문서에서 필요한 정보를 수동으로 추출하는 비효율을 해결하기 위해, OCR 및 텍스트 파싱 기술을 기반으로 구조화된 데이터를 자동으로 추출하는 시스템입니다. 이를 통해 기업은 문서 처리 시간을 단축하고 데이터 활용도를 극대화할 수 있습니다.
수많은 PDF 문서에서 필요한 정보를 수동으로 찾아 추출하는 시간 소모와 오류 발생 문제를 해결합니다.
금융기관, 법률사무소, 정부기관, 제조업체, 교육기관, 연구소
IoT 솔루션
AI, OCR, 텍스트 파싱, 자동화 기술
PDF 정보 추출 시스템
PDF 업로드 및 OCR 추출
일괄 처리 현황
다양한 형식의 PDF 문서를 자동으로 분석하여 텍스트, 이미지, 표 등의 요소를 식별하고 구조화합니다. 복잡한 레이아웃도 정확하게 처리하여 데이터 추출의 기반을 마련합니다.
이미지 기반 PDF나 스캔된 문서 내의 텍스트를 고정밀 OCR(광학 문자 인식) 기술로 인식합니다. 한글, 영어 등 다국어 지원을 통해 다양한 문서 유형에 대응합니다.
파싱 및 OCR을 통해 인식된 텍스트에서 특정 패턴(예: 날짜, 금액, 이름, 주소 등)을 기반으로 핵심 정보를 추출하고, CSV, JSON, XML 등 원하는 형식으로 구조화합니다.
수십, 수백 개의 PDF 문서를 동시에 업로드하여 자동으로 처리할 수 있는 기능을 제공합니다. 대량의 문서도 효율적으로 관리하고 빠르게 결과를 얻을 수 있습니다.
스캔된 이미지 PDF, 텍스트 기반 PDF, 그리고 다양한 레이아웃의 문서(표, 양식 포함) 모두에서 정보 추출이 가능합니다. OCR 기술을 통해 이미지 기반 문서도 처리합니다.
최신 AI 기반 OCR 및 텍스트 파싱 기술을 활용하여 높은 정확도를 제공합니다. 특히 정형화된 문서의 경우 95% 이상의 정확도를 기대할 수 있으며, 비정형 문서도 학습을 통해 정확도를 지속적으로 향상시킬 수 있습니다.
추출된 데이터는 CSV, JSON, XML 등 다양한 표준 형식으로 제공됩니다. 고객의 기존 시스템과의 연동을 위해 맞춤형 데이터 형식 지원도 가능합니다.
모든 문서 처리 과정에서 데이터 암호화 및 접근 제어 등 강력한 보안 프로토콜을 적용합니다. 고객의 민감한 정보는 안전하게 보호되며, GDPR 및 국내 개인정보보호법 등 관련 규정을 준수합니다.
네, RESTful API를 통해 ERP, CRM, ECM 등 고객사의 기존 시스템과 유연하게 연동할 수 있습니다. 맞춤형 통합 지원을 통해 원활한 워크플로우 구축을 돕습니다.